
Sommaire · 14 chapitres
- 01Qu'est-ce qu'un data engineer freelance ?
- 02Ce que je fais moi-même, et ce que je confie
- 03Les missions types d'un data engineer
- 04Les compétences à vérifier
- 05Combien coûte un data engineer freelance en France ?
- 06Où trouver un data engineer freelance ?
- 07Le déroulé d'une mission bien cadrée
- 08Les livrables à exiger
- 098 questions à poser avant de signer
- 10Les erreurs fréquentes
- 11L'IA change-t-elle le métier ?
- 12Qui suis-je ?
- 13Questions fréquentes
- 14Parlons de votre projet
Vous trouverez ici ce que font ces profils, en quoi ils diffèrent d'un data analyst ou d'un data scientist, les technologies à vérifier, ce qui fait le tarif en France, où trouver des freelances fiables et les questions à poser avant de signer.
Qu'est-ce qu'un data engineer freelance ?
1.1Définition et rôle dans l'entreprise
Le data engineer construit la tuyauterie de la donnée. Il relie les systèmes sources (CRM, ERP, analytics, base de commandes, API de partenaires) à un entrepôt central, transforme les données brutes en tables propres et documentées, puis automatise l'ensemble pour que les chiffres soient à jour chaque jour sans intervention manuelle.
Son travail est réussi quand personne n'en parle : les rapports arrivent à l'heure, les chiffres concordent d'un logiciel à l'autre, et les analystes se consacrent à l'analyse plutôt qu'à copier des fichiers.
1.2Data engineer, data analyst, data scientist : qui fait quoi ?
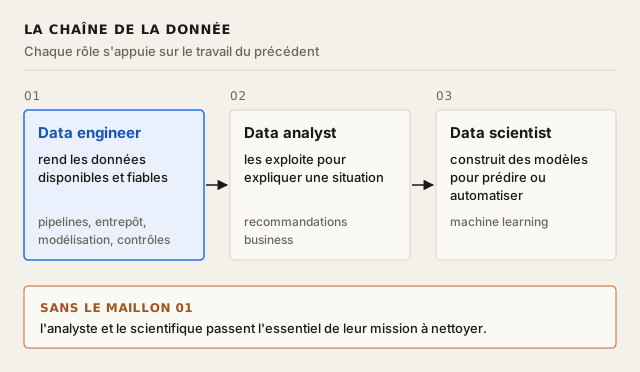
- Le data engineer rend les données disponibles et fiables : pipelines, entrepôt, modélisation, contrôles.
- Le data analyst les exploite pour expliquer une situation et produire des recommandations business.
- Le data scientist construit des modèles de machine learning pour prédire ou automatiser une décision.
L'ordre compte : sans data engineering, l'analyste et le scientifique de la donnée passent l'essentiel de leur mission à nettoyer.
1.3Pourquoi les entreprises font appel à des freelances
Beaucoup de missions de data engineering ont un début et une fin : construire un premier entrepôt, migrer des chargements vers AWS ou Google Cloud, reprendre une chaîne fragile. Les freelances apportent une expertise pointue le temps du projet, sans recrutement long, et laissent derrière eux une documentation que vos développeurs reprennent.
Ce que je fais moi-même, et ce que je confie
Mon terrain est la donnée marketing et web, au cœur de mon offre tracking et analytics. Dans ce contexte, j'assure la mise en place de :
- l'export de GA4 vers BigQuery et le choix du mode d'export ;
- la modélisation des événements en tables lisibles (sessions, conversions, sources d'acquisition) dans GCP BigQuery ;
- le rapprochement avec le CRM ou les ventes, et les contrôles de cohérence entre sources ;
- les rapports Looker Studio branchés sur ces tables.
La documentation officielle précise que l'export quotidien d'une propriété GA4 standard est limité à un million d'événements par jour, alors que l'export en continu n'a pas de limite de volume : ce choix se fait dès le cadrage.
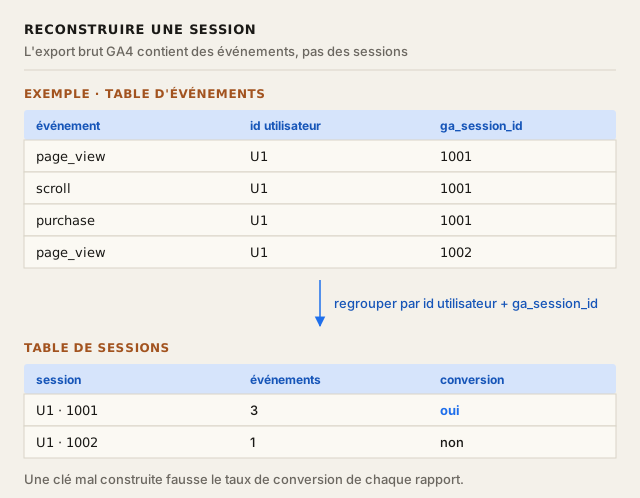
Un exemple de piège typique : dans l'export brut, une session n'existe pas sous forme de ligne. Il faut la reconstruire à partir de l'identifiant de l'utilisateur et du paramètre ga_session_id porté par chaque événement. Une table de sessions mal reconstruite donne des taux de conversion faux dans tous les rapports qui en dépendent.
Quand le projet dépasse ce cadre (projet multi-sources, streaming avec Kafka, traitements Spark sur de gros volumes, migration d'un Teradata vers Snowflake ou Databricks), je ne joue pas au spécialiste. Je cadre le besoin, je sélectionne un data engineer expérimenté parmi les profils que je connais, et je peux suivre la mission à vos côtés : périmètre, livrables, vérification des données livrées.
Mes critères de sélection sont ceux que je vous conseille plus bas : une chaîne réelle déjà construite sur votre fournisseur, montrée avec son code et sa documentation, une façon claire de tester les chargements, et la disponibilité effective pour votre calendrier. Je vérifie aussi que le profil sait expliquer ses choix à un interlocuteur non spécialiste.
Les missions types d'un data engineer
3.1Conception de l'entrepôt
Choix de l'entrepôt (BigQuery, Snowflake, Redshift, Databricks), découpage en couches (données brutes, nettoyées, prêtes pour l'usage), conventions de nommage, gestion des accès et sécurité. Un schéma simple et documenté vaut mieux qu'une architecture à la mode.
3.2Collecte, intégration et transformation (ETL ou ELT)
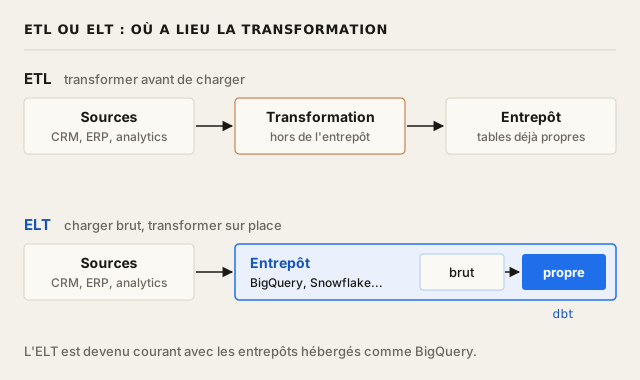
En ETL, on transforme avant de charger ; en ELT, on charge d'abord les données brutes dans l'entrepôt puis on transforme sur place, souvent avec dbt. Le second modèle est devenu courant avec les entrepôts hébergés comme BigQuery. L'intégration des sources passe par des connecteurs du marché (Fivetran, Airbyte) ou des solutions plus anciennes comme Talend.
3.3Ordonnancement des traitements
Les chargements s'enchaînent dans un ordre précis et doivent reprendre proprement après un échec. Apache Airflow reste la référence de l'orchestration ; Dagster et Prefect sont des alternatives récentes.
3.4Contrôles et surveillance
Tests automatiques sur les volumes, les doublons, les valeurs nulles, les clés orphelines ; alertes quand un chargement n'arrive pas ; rapprochement régulier avec la source. C'est la partie la plus souvent négligée, et la plus coûteuse quand elle manque : la qualité des données se construit, elle ne se constate pas après coup.
3.5Exploitation et évolution
Optimisation des coûts de requête, ajout de nouvelles sources, documentation, passage de relais aux collaborateurs internes, veille sur les nouvelles versions des logiciels.
Les compétences à vérifier
- Maîtrise de SQL avancé et de Python : le socle de tout data engineer ; Scala pour certains environnements Spark.
- Cloud : AWS, GCP ou Azure, selon votre environnement ; une expérience réelle sur votre fournisseur fait gagner des semaines.
- Transformation et calcul distribué : dbt, Spark.
- Orchestration : Airflow ou équivalent.
- Pratiques DevOps appliquées à la donnée : versionnement Git, déploiement automatisé, conteneurs (Docker).
- Modélisation : schémas en étoile, gestion de l'historique, conception orientée usage BI.
- Communication : savoir expliquer un choix d'outillage à un métier non technique.
Les certifications des fournisseurs (AWS, GCP, Azure) attestent de connaissances ; elles ne remplacent pas un exemple concret de chaîne construite et surveillée en production.
4.1Senior, lead ou architect : quel profil viser ?
Un profil confirmé construit seul un périmètre défini. Un lead data engineer organise le travail de plusieurs data engineers et assure le management technique. Un data architect conçoit l'ensemble et arbitre entre les solutions. Pour une PME qui démarre, un senior autonome suffit souvent ; pour un grand groupe, l'architect intervient en amont.
Combien coûte un data engineer freelance en France ?
Le taux journalier se négocie au cas par cas. Les baromètres publiés en ligne regroupent sous un même intitulé le décisionnel, la BI, le big data et l'ingénierie des données : leurs moyennes donnent une tendance, pas le prix d'une personne précise.
Ce qui fait varier le prix : l'expérience, la rareté de la stack (Kafka, Scala), le fournisseur concerné, le niveau de responsabilité, la longueur de l'engagement, la région et le passage par un intermédiaire.
Pour comparer deux candidats, ramenez chaque offre au même nombre de jours, puis regardez ce qu'elle couvre : pipelines, tests, supervision, documentation, transfert à votre équipe. Je ne publie pas de grille pour mes propres prestations : je chiffre chaque projet après un premier échange.
Où trouver un data engineer freelance ?
- Plateformes de freelances : Malt, Free-Work, Freeland, Le Hibou, Freelance Informatique, Comet ; pratiques pour comparer rapidement des profils et des tarifs.
- Sociétés de conseil et ESN : utiles pour un besoin de plusieurs profils, avec une marge d'intermédiaire.
- Recommandation : un expert recommandé par un pair qui l'a vu travailler a déjà passé le premier filtre.
- Groupes et meetups tech : plus longs à explorer, riches en profils pointus.
Quelle que soit la voie, demandez un exemple de chaîne réelle, la documentation qui l'accompagne et la façon dont elle était surveillée.
Le déroulé d'une mission bien cadrée
- 1Cadrage : sources à connecter, usages attendus, fréquence de mise à jour, contraintes de sécurité et de conformité.
- 2Schéma cible : une page, validée avant d'écrire du code.
- 3Développement par lots : une première source de bout en bout, utilisable par les métiers, avant d'ajouter les suivantes.
- 4Tests et alertes, posés au fil de l'eau et non en fin de projet.
- 5Documentation et transmission : vos collaborateurs doivent pouvoir faire évoluer les chargements sans le freelance.
Les livrables à exiger
- un schéma d'ensemble à jour ;
- le code (requêtes, modèles, scripts, planification des tâches) dans votre dépôt Git, pas dans celui du prestataire ;
- un catalogue des tables : définition, source, fréquence, propriétaire ;
- les tests de fiabilité et les règles d'alerte ;
- un mode opératoire en cas d'échec d'un chargement ;
- une estimation du coût mensuel des ressources consommées.
8 questions à poser avant de signer
- 1Avez-vous déjà travaillé sur mon fournisseur (AWS, GCP, Azure) et sur ma stack ?
- 2Quel schéma proposez-vous, et pourquoi pas une plus simple ?
- 3Comment testez-vous les données à chaque chargement ?
- 4Que se passe-t-il quand un traitement échoue la nuit ?
- 5Le code et les accès restent-ils sous mon contrôle ?
- 6Combien coûtera la solution chaque mois en ressources ?
- 7Comment documentez-vous ce que vous construisez ?
- 8Qui pourra faire évoluer les chaînes après votre départ ?
Les erreurs fréquentes
- Construire une plateforme data avant de savoir quelles questions elle doit servir.
- Choisir la technologie la plus récente plutôt que celle que l'équipe saura reprendre.
- Reporter les contrôles « à plus tard » : un chiffre faux découvert par la direction coûte cher en confiance.
- Laisser le code et les accès chez le prestataire.
- Oublier le coût des requêtes, qui grimpe vite sans surveillance.
L'IA change-t-elle le métier ?
L'IA générative accélère l'écriture de requêtes, de scripts et de documentation, et rend l'interrogation des données plus accessible aux métiers. Elle rend aussi la fiabilité plus critique : un assistant IA branché sur des tables mal définies répond vite et faux. Les projets d'intelligence artificielle, de machine learning et de data science commencent donc presque toujours par un chantier d'ingénierie des données. Voir aussi ma page freelance IA.
Qui suis-je ?
Je suis diplômé de l'École Centrale Paris (aujourd'hui CentraleSupélec) et de l'ESSEC Business School. Je programme depuis l'âge de 12 ans et je m'intéresse à l'analyse de données depuis mes études.
Mon activité tient en trois offres de services : SEO et GEO, tracking et analytics (GA4, Google Tag Manager, Matomo, Consent Mode), et CRO et growth. J'ai conçu mes propres outils SEO et GEO, comme SERPmantics, que j'emploie en mission.
Accenture, Lecourtier, Crono Concept, Pentalog, PatternsWizard, La Méthode Martinez et Skill Value comptent parmi mes clients. Plus de détails : à propos et mon profil LinkedIn.


Questions fréquentes
Q01Quel est le TJM moyen d'un data engineer freelance ?
Il n'existe pas de TJM unique : il dépend du parcours, de la stack, de la longueur de l'engagement et de la région. Les moyennes publiées mêlent des parcours très différents ; comparez des candidats comparables, sur un même périmètre.
Q02Faut-il être certifié cloud ?
Ce n'est pas obligatoire. Une certification est un plus, mais un exemple concret de chaîne en production compte davantage.
Q03Un data engineer peut-il travailler à distance ?
Oui, l'essentiel du travail se fait sur des services accessibles à distance, avec des accès nominatifs que vous contrôlez. Je travaille à distance, en France et à l'international.
Q04Combien de temps dure une mission de data engineering ?
De quelques semaines pour une première source à plusieurs mois pour un socle complet, selon le nombre de sources et le niveau d'automatisation visé.
Parlons de votre projet
Décrivez-moi vos sources, vos logiciels et ce que vous voulez piloter : je vous dis ce que je peux construire moi-même et, si besoin, quel profil solliciter. Me contacter.